한 번 얻은 서버 지식을 기기에 쌓아 비슷한 문제에 활용… 처리 속도 최대 2.80배 빨라져, 유럽컴퓨터비전학회(ECCV 2026)서 발표
어려운 문제를 풀 때마다 전문가에게 다시 묻는 대신, 한 번 배운 풀이를 공책에 적어두고 비슷한 문제에 활용하는 인공지능 기술이 나왔다. KAIST(총장 배충식)는 전산학부 이재길 교수 연구팀이 기기의 소형 AI와 서버의 대형 AI를 효율적으로 연결하는 기기-서버 협업 기술 ‘CURE(Cumulative Knowledge Reuse, 누적 지식 재사용)’를 개발했다고 21일 밝혔다. 연구팀은 이 기술로 높은 정확도를 유지하면서 서버 호출 횟수를 평균 55.61% 줄이는 성과를 확인했다.
스마트폰과 같은 기기는 계산 능력과 메모리가 제한돼 가벼운 소형 AI 모델을 주로 사용한다. 소형 모델은 간단한 문제는 빠르게 처리하지만 복잡하거나 낯선 이미지를 구분할 때는 정확도가 떨어질 수 있다. 반대로 모든 문제를 고성능 서버의 대형 AI에 맡기면 정확도는 높아지지만 데이터를 보내고 답을 기다리는 시간이 길어지고, 통신량과 서버 연산량이 늘어 이용자 대기 시간과 서비스 운영 비용이 커진다. 이를 보완하기 위해 기기의 소형 AI가 먼저 판단하고 어려운 문제만 서버로 보내는 협업 방식이 연구돼 왔지만, 기존 방식은 서버에서 받은 답을 그때만 사용하기 때문에 비슷한 문제가 다시 들어와도 서버에 같은 도움을 반복해서 요청해야 하는 한계가 있었다.
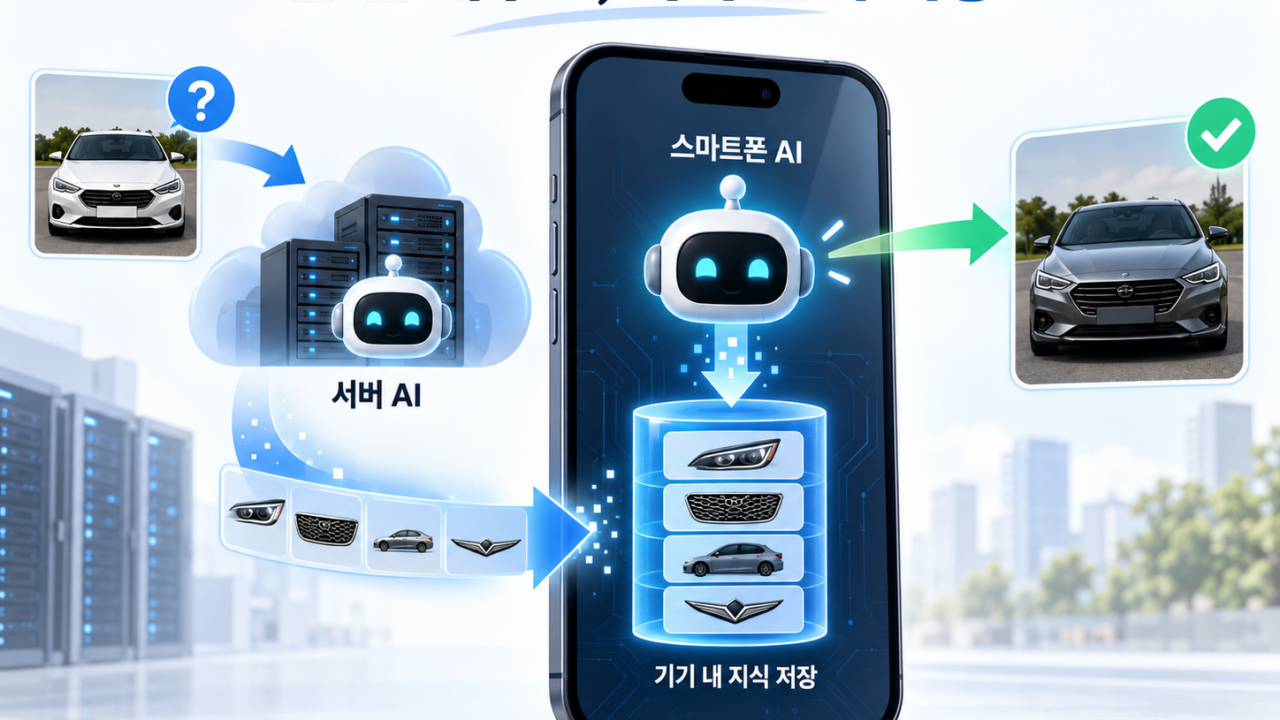
CURE는 먼저 기기의 소형 AI가 입력을 스스로 처리할 수 있는지 판단한다. 해결하기 어렵다면 기기에 저장된 서버 지식을 활용하고, 저장된 지식으로도 부족할 때만 서버에 도움을 요청한다. 이른바 ‘혼자 풀기, 배운 내용 찾아보기, 전문가에게 묻기’의 3단계로 문제를 처리하는 방식이다. 예를 들어 소형 AI가 사진 속 특정 차종을 구분하지 못하면 서버의 대형 AI에 답을 요청하는데, 이때 CURE는 서버의 판단 결과와 이미지의 특징을 기기의 지식 저장소에 반영한다. 이후 비슷한 차종의 사진이 들어오면 앞서 저장한 지식을 참고해 서버에 다시 묻지 않고 기기에서 직접 판단한다.
특히 CURE는 서버가 처리한 사진을 하나씩 그대로 저장하지 않는다. 같은 종류의 이미지에서 나타나는 특징의 평균과 분산을 확률분포로 표현해 요약한 뒤 지식으로 보관하는 ‘분포 기반 지식 저장소’ 방식을 쓴다. 자동차 사진을 통째로 외우는 대신 차체 모양이나 전조등처럼 차종을 구분하는 핵심 특징을 정리해 두는 것과 같은 원리로, 개별 사례를 대량으로 보관하지 않고도 이전에 본 사진뿐 아니라 처음 접하는 유사한 사진을 판단할 때 축적된 지식을 활용할 수 있다.
연구팀은 이미지와 글을 함께 이해하는 비전-언어 모델을 이용해 CURE의 성능을 검증했다. 기기용 소형 모델로는 MobileCLIP2를, 서버용 대형 모델로는 180억 개의 매개변수를 가진 EVA-CLIP을 사용해 다양한 이미지 분류 데이터셋으로 실험했다. 그 결과 CURE는 모든 입력을 대형 서버 모델로 처리하는 방식에 근접한 정확도를 유지하면서, 서버의 지식을 축적하지 않는 기존 기기-서버 협업 방식보다 서버 호출 횟수를 평균 55.61% 줄였다. 처리 속도는 기존 협업 방식보다 최대 2.80배, 모든 입력을 서버로 보내는 방식보다 최대 3.67배 빨랐다.
CURE는 소형 모델과 서버 모델을 별도로 다시 학습시키지 않고도 적용할 수 있다는 점도 특징이다. 기존 AI 모델은 그대로 두고 서버에서 얻은 지식을 담는 별도의 저장소를 붙이는 방식이어서, 별도의 학습 데이터나 학습 비용 없이 다양한 AI 모델과 서비스에 유연하게 적용할 수 있다.
이 기술은 모바일 사진 인식과 이미지 검색 등에서 반복적인 데이터 전송과 서버 연산을 줄여 이용자의 대기 시간과 서비스 운영 부담을 낮추는 데 활용될 수 있다. 스마트폰뿐 아니라 제한된 기기 자원으로 주변 환경을 인식해야 하는 로봇과 웨어러블 기기에도 응용할 수 있으며, 특히 통신이 느리거나 불안정한 환경에서 로봇이 서버의 답을 기다리지 않고 이전에 얻은 지식을 바탕으로 현장에서 직접 판단하는 데 도움을 줄 수 있다. 다만 연구팀은 실제 적용 효과가 기기의 성능과 저장 공간, 통신 환경, 입력 데이터의 특성 등에 따라 달라질 수 있어 다양한 기기와 환경에서 추가 검증이 필요하다고 설명했다.
이재길 교수는 “CURE는 기기의 소형 AI가 서버에 같은 문제를 반복해서 묻지 않고, 한 번 얻은 지식을 기억해 다시 활용하도록 한 기술”이라며 “높은 정확도를 유지하면서 통신 부담과 응답 시간을 줄여 스마트폰과 로봇, 웨어러블 등 다양한 기기에서 고성능 AI를 효율적으로 활용하는 기반이 될 것으로 기대한다”고 말했다.
이번 연구에는 KAIST 정보전자연구소 이영준 박사후연구원이 제1저자로, 전산학부 이재길 교수가 교신저자로 참여했다. Amazon 김도영 연구원, LG AI연구원 강준혁 연구원, KAIST 산업및시스템공학과 송환준 교수가 공동저자로 함께했다. 연구 결과는 지난 9월 8일부터 12일까지 스웨덴 말뫼에서 열린 컴퓨터 비전 분야 주요 국제학술대회인 유럽컴퓨터비전학회(ECCV 2026)에서 10일 발표됐으며, 논문명은 ‘CURE: Cumulative Knowledge Reuse for Efficient Device-Server Hybrid Inference in Vision-Language Models’다.
한편 이번 연구는 과학기술정보통신부와 정보통신기획평가원의 ‘사람중심인공지능핵심원천기술개발사업’ 가운데 ‘AI학습능력개선기술개발’ 과제의 지원 등을 받아 수행됐다.
#KAIST #CURE #기기서버협업 #비전언어모델 #ECCV2026
답글 남기기