비인간 언어 프롬프트로 단일 카메라 영상 깊이 인식 구현… 자율주행·로봇·AR 활용 기대
한국에너지공과대학교(KENTECH, 총장직무대행 박진호) 이석주 교수 연구팀이 인공지능의 공간 이해 능력을 한 단계 끌어올리는 성과를 냈다. 연구팀은 비전-언어 모델(VLM)의 3차원 공간 추론을 가능하게 하는 경량 프롬프트 학습 기술을 개발했다고 10월 1일 밝혔다. 이번 기술은 단일 카메라 영상만으로도 물체의 거리와 깊이를 정밀하게 파악할 수 있게 해, 기존 인공지능이 갖고 있던 기하학적 한계를 극복한 것으로 평가된다.
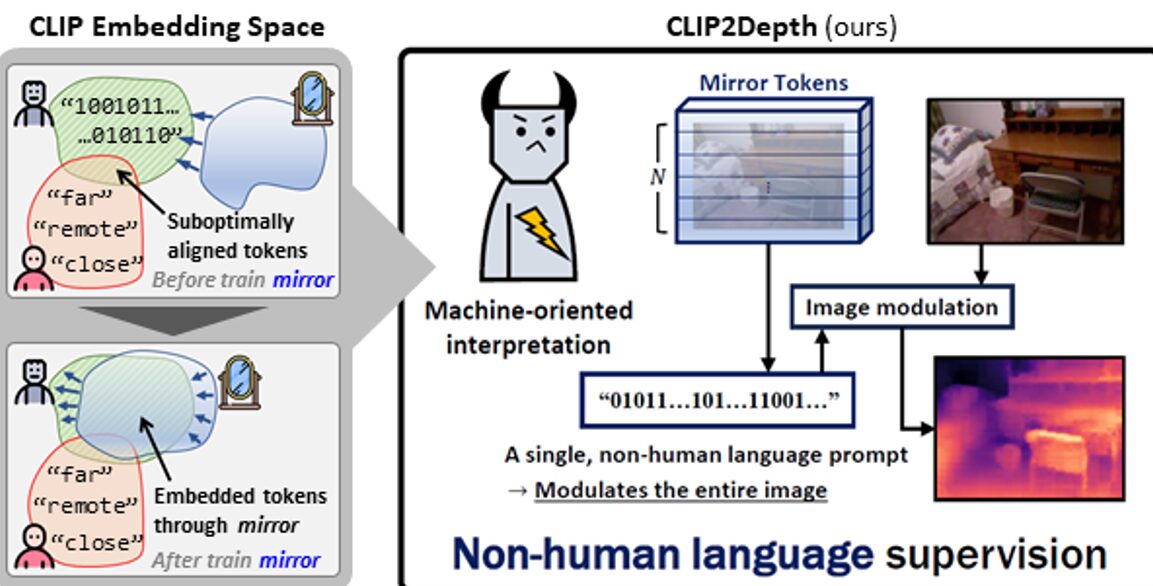
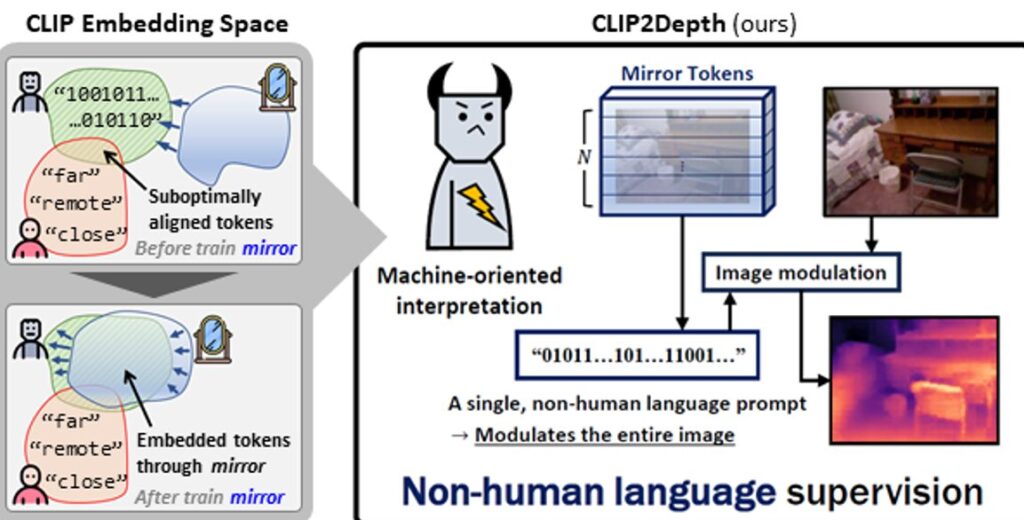
기존의 CLIP과 같은 멀티모달 비전-언어 모델은 텍스트와 이미지를 동시에 이해할 수 있지만, 거리·깊이 인식 등 공간 정보 추론에는 취약했다. 연구팀은 이를 해결하기 위해 사람이 쓰는 언어 대신 기계가 이해하기 최적화된 ‘비인간 언어 프롬프트’를 도입했다. 이 방식을 통해 인공지능은 이미지 속 깊이 정보를 훨씬 효과적으로 반영할 수 있었고, 그 결과 단일 카메라 기반의 깊이 추정 기술에 응용 가능성이 열리게 됐다.
연구 결과, 이번 기술은 약 110만 개 학습 파라미터만으로도 기존 대형 모델(3억 개 이상)에 견줄 만한 성능을 보였다. 필요한 파라미터 수를 300분의 1 수준으로 줄였음에도 성능 저하 없이 학습이 가능했던 것이다.
이석주 교수는 “자율주행차, 로봇 비전, 증강현실(AR) 등 경량화가 필수적인 다양한 공간 컴퓨팅 분야에서 활용할 수 있는 원천기술”이라고 강조했다. 이번 성과는 컴퓨터 비전 및 기계학습 분야 세계적 권위 학술지 『Pattern Recognition』(Elsevier, SCIE Q1, IF=7.6)에 9월 26일 온라인 게재됐다. 논문 제목은 “CLIP Can Understand Depth”로, 연구 성과는 국제적으로도 학문적 가치를 인정받았다. 연구는 산업통상자원부, 한국연구재단, 한국천문연구원의 지원을 받아 수행됐다.
이번 연구는 인공지능이 단순히 사물의 형태와 이름을 인식하는 단계를 넘어, 공간적 깊이까지 이해할 수 있도록 발전시켰다는 점에서 큰 의미를 가진다. 자율주행차의 안전성 향상, 로봇의 정밀 작업 수행, 증강현실 기반 메타버스 기술 구현 등 광범위한 분야에서 파급력이 클 것으로 전망된다.
#KENTECH #공간추론 #프롬프트학습 #3D인공지능 #PatternRecognition #자율주행 #로봇비전 #증강현실

답글 남기기