영상 전체가 아니라 ‘정답의 핵심 장면’만 정확히 짚어내는 CORTEX 프레임워크 개발… 자율주행·로봇·보안 분야 활용 기대
AI가 질문에 답할 때 영상 전체를 보지 않고 언어 패턴을 기반으로 ‘그럴듯한 답’을 추측하는 문제는 멀티모달 AI의 대표적 한계로 지적돼 왔다. KAIST 전산학부 윤성의 교수 연구팀은 이 한계를 해결하기 위해 영상 속에서 정답 판단에 꼭 필요한 ‘딱 그 순간(Trigger moment)’을 AI가 스스로 찾아내는 기술을 개발했다. 연구팀은 이 기술을 기반으로 세계적 권위의 컴퓨터 비전 학회 ICCV 2025에서 열린 Perception Test Challenge의 ‘영상 근거 기반 질의응답(Grounded VideoQA)’ 트랙에서 1위를 차지했다.
새롭게 개발된 CORTEX(Chain-of-Reasoning for Trigger Moment Extraction)는 세 종류의 모델이 단계적으로 협업하는 구조다. 첫 번째 단계에서는 추론 AI(Gemini 2.5 Pro)가 질문을 분석해 “답을 위해 꼭 봐야 할 순간” 후보를 찾아낸다. 두 번째 단계에서는 Molmo-7B 기반 ‘Grounding 모델’이 해당 장면 속 사람·차·사물의 좌표를 정밀하게 파악한다. 세 번째로 Meta SAM2 기반 ‘Tracking 모델’이 그 장면을 중심으로 앞뒤 시간대에서 객체의 움직임을 따라가며 추적 오류를 최소화한다. 이 과정을 통해 AI는 영상 전체를 무작정 훑지 않고 핵심 장면을 중심으로 정확한 근거 기반 판단을 수행할 수 있다.
CORTEX를 적용한 KAIST 팀 SGVR Lab은 대회 평가 지표인 ‘고차 추적 정확도(HOTA)’에서 0.4968점을 기록해 2위 콜럼비아대(0.4304점)를 크게 앞섰다. 이는 전년도 우승 기록인 0.2704점보다 약 2배 가까운 점수로, AI가 영상 속 실제 행동과 객체의 시간적 변화까지 정확하게 잡아낸 성과다. 페이지 내 그림 1은 CORTEX의 파이프라인을, 그림 2·3은 구두 발표와 연구진 사진을 보여주며, 그림 4에는 Perception Test Grounded VideoQA 우승 인증서가 수록되어 있다.
영상 속 ‘결정적 순간’을 정확히 포착해 판단하는 능력은 AI의 실제 적용 범위를 크게 넓힌다. 자율주행차는 사고 위험이 있는 장면을 정확히 감지하고, 로봇은 복잡한 환경에서 사람이 보지 못한 움직임까지 파악해 정교하게 행동할 수 있다. 보안·감시 시스템은 수많은 영상 중 주요 장면만 빠르게 찾아낼 수 있으며, 방송·스포츠·미디어 분석에서는 사람이나 사물의 행동을 시간축에서 정밀하게 추적하는 데 활용된다.
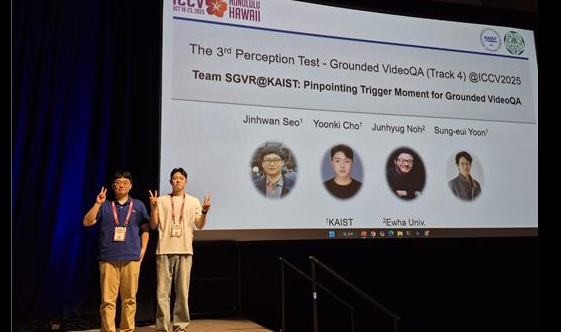
연구 성과는 ICCV 2025 Perception Test Challenge에서 발표되었으며, 논문은 Pinpointing Trigger Moment for Grounded VideoQA라는 제목으로 공개되었다. 프로젝트는 과학기술정보통신부 기초연구사업, SW스타랩, AGI 관련 국가 R&D 사업의 지원으로 수행됐다.
윤성의 교수는 이번 성과가 “AI가 언어가 아닌 실제 영상 근거를 바탕으로 판단하도록 만드는 근본 기술”이라며, 향후 다양한 4D·실세계 기반 AI 시스템의 신뢰성과 안전성을 강화하는 기반이 될 것이라고 밝혔다.
#KAIST #CORTEX #TriggerMoment #GroundedVideoQA #ICCV2025 #GoogleDeepMind #영상AI #스포트라이트유
답글 남기기